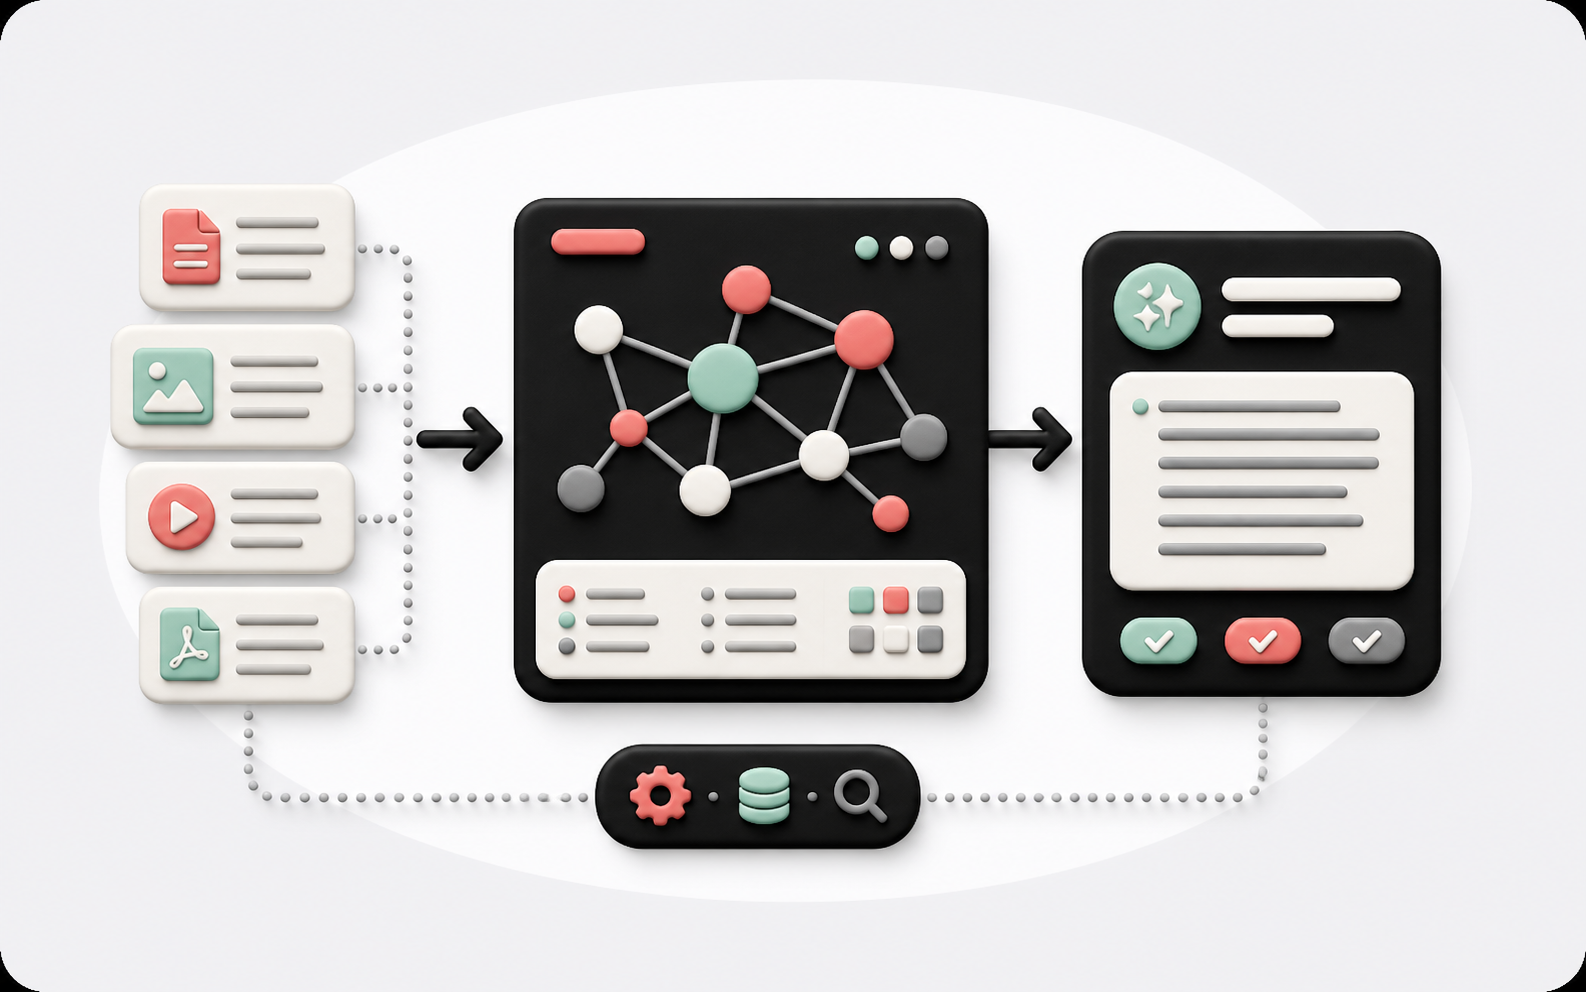
从资料中整理实体、关系和属性
输入文档样例、数据库字段、业务对象或常见问题,Kollab 会帮你拆出适合建图的核心实体、关系类型、关键属性、去重规则和抽取提示词。
输入你的文档类型、业务对象、问答场景或现有 RAG 问题,Kollab 会帮你整理知识图谱结构、Neo4j 建模思路、LangChain 检索流程、证据引用方式和上线评估清单。
如果普通向量检索已经很难回答多跳问题、关系问题或需要证据链的问题,可以用知识图谱把实体和关系显式建模,再和向量检索一起组成更可靠的 RAG 流程。
输入文档样例、数据库字段、业务对象或常见问题,Kollab 会帮你拆出适合建图的核心实体、关系类型、关键属性、去重规则和抽取提示词。
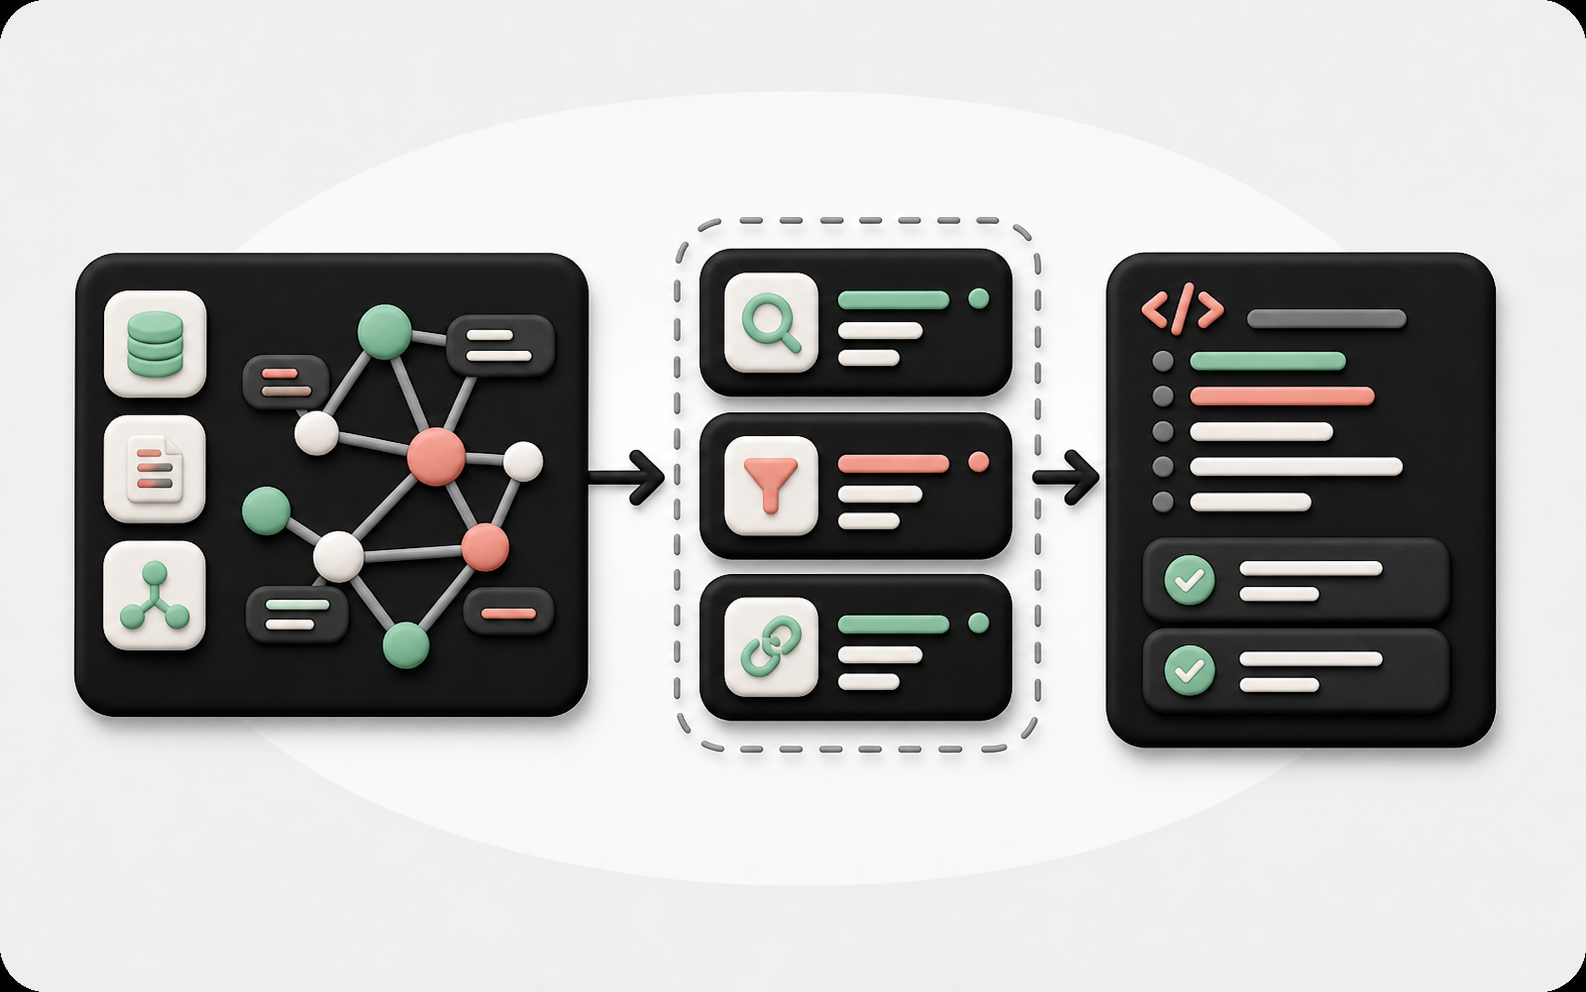
把纯向量 RAG 升级成图检索与向量检索结合的流程:先识别问题里的实体,再决定是否查询 Neo4j、如何写 Cypher、怎样补充向量召回结果,并把证据合成为回答。
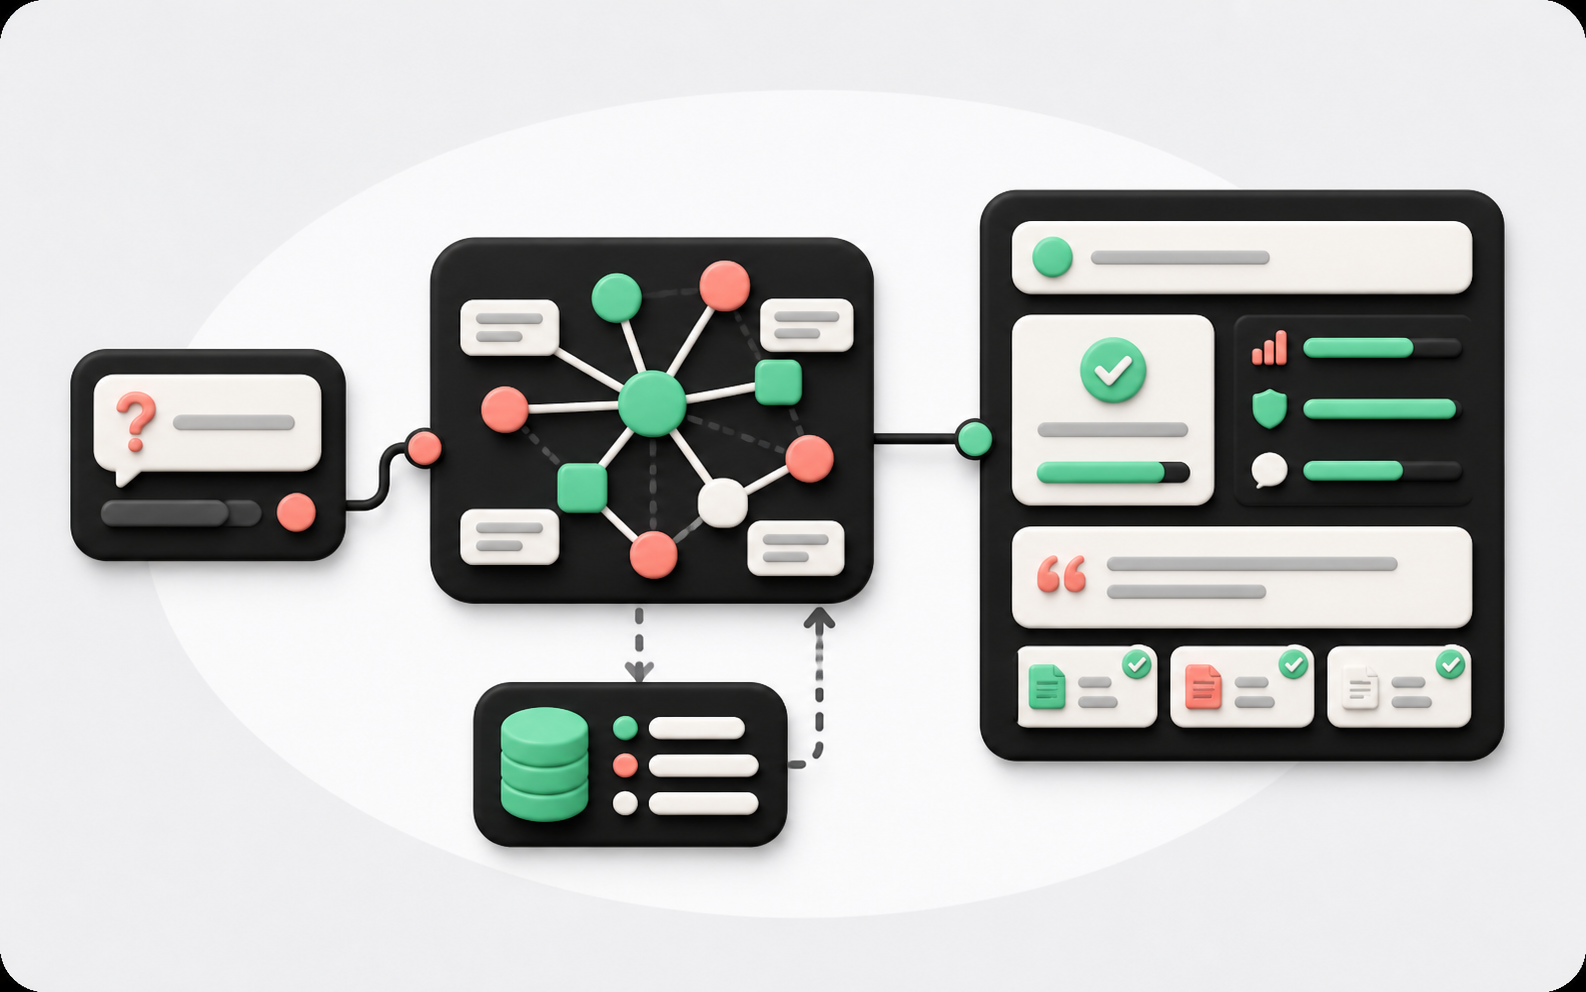
面向企业知识库和 AI Agent 场景,Kollab 会继续整理图谱记忆的更新方式、证据引用规则、冲突处理方式,以及准确率、覆盖率、延迟和维护成本等评估项。
Kollab 会把“我要做 Graph RAG”拆成清楚的实施步骤:建模、抽取、索引、检索、回答合成和评估。每一步都可以继续扩写成技术文档、任务清单或代码实现计划。
粘贴文档类型、业务对象、样例内容、常见问题,或你现在的 RAG 失败案例。
得到实体、关系、属性、约束、抽取提示词和 Neo4j 建模建议。
规划图检索、向量检索、重排、上下文压缩和回答合成的协作方式。
继续生成开发任务、评估样例、上线风险和团队分工,方便进入原型开发。
无论你是在升级企业知识库、验证 Neo4j 原型、设计 LangChain 检索器,还是为 AI Agent 增加长期记忆,都可以先生成一份结构化方案。
把文档片段进一步整理成产品、制度、客户、事件和关系,提升复杂问题的可解释性。
在开发前准备图谱结构、查询方向、数据导入任务和验证问题。
说明实体识别、图查询、向量召回、重排和回答合成如何配合。
把用户、项目、事件、决策和事实沉淀成可更新、可检查的图谱记忆。
普通 RAG 常按相似度召回文本片段。知识图谱 RAG 会额外建模实体和关系,更适合多跳问题、关系推理和需要证据链的问题。
不一定。Neo4j 是常见选择,但你也可以把生成的图谱结构和检索流程迁移到其他图数据库或现有数据栈。
可以。工具会整理检索器流程、提示词结构、图查询逻辑和评估项,方便你继续推进 LangChain 原型。
可以。生成结果可以继续扩写成架构说明、开发任务、评估样例或团队讨论文档。
输入你的知识库、业务对象和问答目标,生成图谱结构、检索流程、Neo4j 与 LangChain 实施计划,以及上线前评估清单。