Avalie texto à escala com o Jev.
O Jev é um modelo de julgamento estruturado da TypeSafe. Produz booleanos, escolhas e pontuações exatas. Pode processar até 32 perguntas independentes em paralelo por pedido.
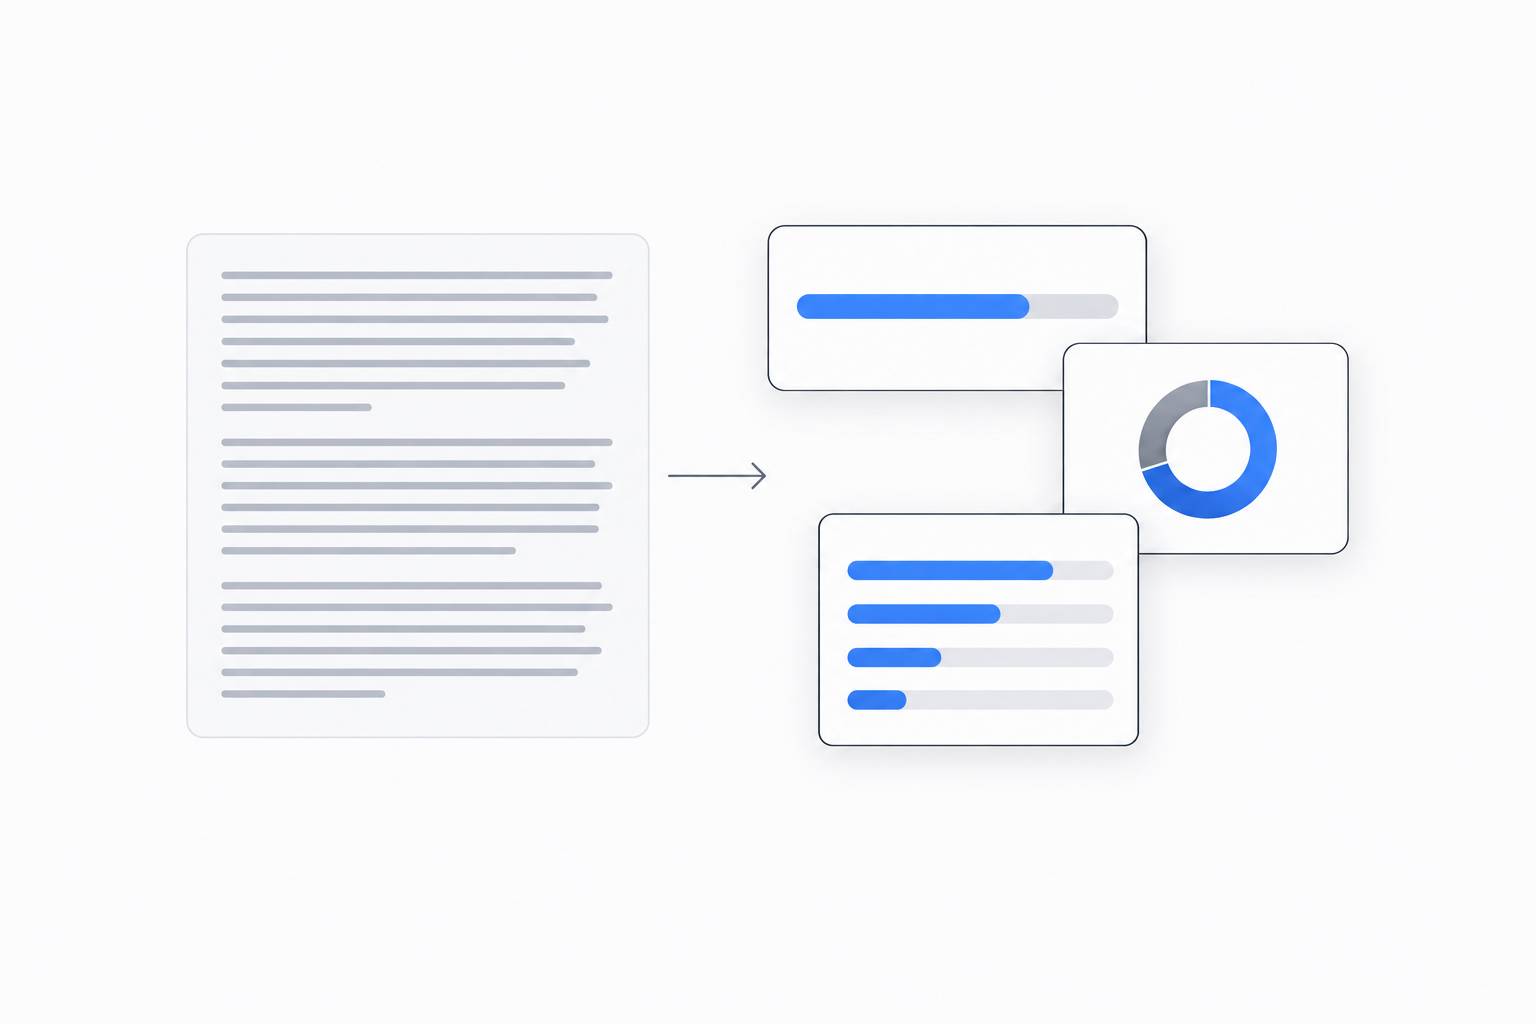
Chame o Jev diretamente a partir da sua área de trabalho.
O Agente Kollab invoca o Jev automaticamente quando pede avaliações estruturadas. Também o pode executar manualmente através da CLI para scripts e pipelines.
npm install -g @kollab/cli
kollab login

echo '{
  "state": "Help! My payouts have been failing for 3 days.",
  "questions": {
    "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" },
    "department": { "type": "choice", "instructions": "Which team should handle this?",
      "criteria": { "billing": "Payments, invoicing, refunds", "technical": "Bugs, outages, integrations", "sales": "Pricing, upgrades, new accounts" } }
  }
}' | kollab tool run jev --json
Parte do arsenal de modelos do Kollab.
Aceda ao Jev em conjunto com um conjunto completo de modelos para tarefas de texto, visão, vídeo e áudio.
Casos de uso de julgamento estruturado.
Execute tarefas de avaliação específicas com o Jev.
Benchmarks de desempenho.
Execução rápida e alta consistência para tarefas de classificação em lote.
13 perguntas numa chamada: 0,27s vs 2,71s para 13 chamadas separadas
TypeSafe cookbookConjunto de dados jurídicos do CLERC, 40 consultas, lista final top-30 do BM25
TypeSafe cookbook6003 avaliações verificadas · 160 US$ vs 33 000 US$ por milhão de julgamentos
Good Start LabsMediana de 0,35s vs 8,83s · detetou 6/7 defeitos inseridos
Every.toConjunto de teste de 5733 emails, próximo dos 98,87% de uma linha de base TF-IDF ajustada
bitnovus (independent)Aplicações no mundo real.
Como os programadores e investigadores estão a utilizar o Jev em produção.
Deteção de Spam e Respostas Automáticas
Freek Van der Herten processa tickets de helpdesk recebidos com 3 perguntas em paralelo em 639ms. Isto alcança 48 pedidos por segundo a um custo mensal de 0,36 US$.
Consistência em Pesquisa Financeira
A Good Start Labs utiliza o Jev para verificar grandes conjuntos de relatórios financeiros de forma eficiente e consistente.
Avaliação do Estilo de Escrita
A Every.to avalia rascunhos de artigos com o Jev. O modelo sinaliza defeitos de escrita inseridos a uma velocidade mediana de 0,35 segundos.
Pontuação de Observabilidade de LLMs
A Langfuse integrou o Jev no seu sistema de avaliação para automatizar a pontuação de prompts e os dados de feedback.
Integração com Cloudflare Workers AI
A Cloudflare adicionou o modelo Jev à sua plataforma Workers AI para inferência edge global.
Anúncio de Financiamento Seed
A TypeSafe AI angariou 40 M US$ para criar modelos especializados para aplicações de software.
Gestão de Estado Estruturado
O Jev alimenta uma demonstração oficial a jogar Doom através de saídas estruturadas de estado do jogo.
Perguntas frequentes.
O que é o Jev e como se diferencia dos modelos de chat padrão?+
O Jev é um modelo de julgamento estruturado. Produz booleanos, escolhas e pontuações exatas. Ignora totalmente o texto de conversação e devolve dados puros.
Como utilizo o Jev no Kollab?+
O Agente Kollab invoca o Jev automaticamente quando descreve uma tarefa que requer julgamento estruturado. Também o pode chamar diretamente a partir do seu terminal utilizando o comando `kollab tool run jev`.
Como é calculado o preço?+
Os tokens de entrada custam 0,042 US$ por milhão. Os tokens de saída são totalmente gratuitos.
O Jev suporta chinês, japonês e coreano?+
Sim. A precisão para as línguas CJK é atualmente inferior à do inglês.
As probabilidades de confiança são absolutamente exatas?+
Auditorias independentes mostram que as probabilidades de saída do Jev não estão estritamente calibradas. Trate-as como pontuações relativas e monotónicas. Recomendamos a verificação por amostragem em tarefas de alto risco.
O Jev consegue processar imagens ou áudio?+
O Jev apenas processa texto simples até 80.000 caracteres. Tem de transcrever o áudio ou extrair o texto das imagens primeiro. O Kollab fornece outros modelos, como o GPT Image 2 e o Grok STT, para o processamento direto de multimédia.
Comece a avaliar texto com o Jev.
Execute tarefas de classificação e pontuação de alto volume diretamente na sua área de trabalho.