使用 Jev 大規模評估文本。
Jev 是由 TypeSafe 推出的結構化判斷模型。它能輸出精確的布林值、選擇與評分結果。您可以在單次請求中平行處理多達 32 個獨立問題。
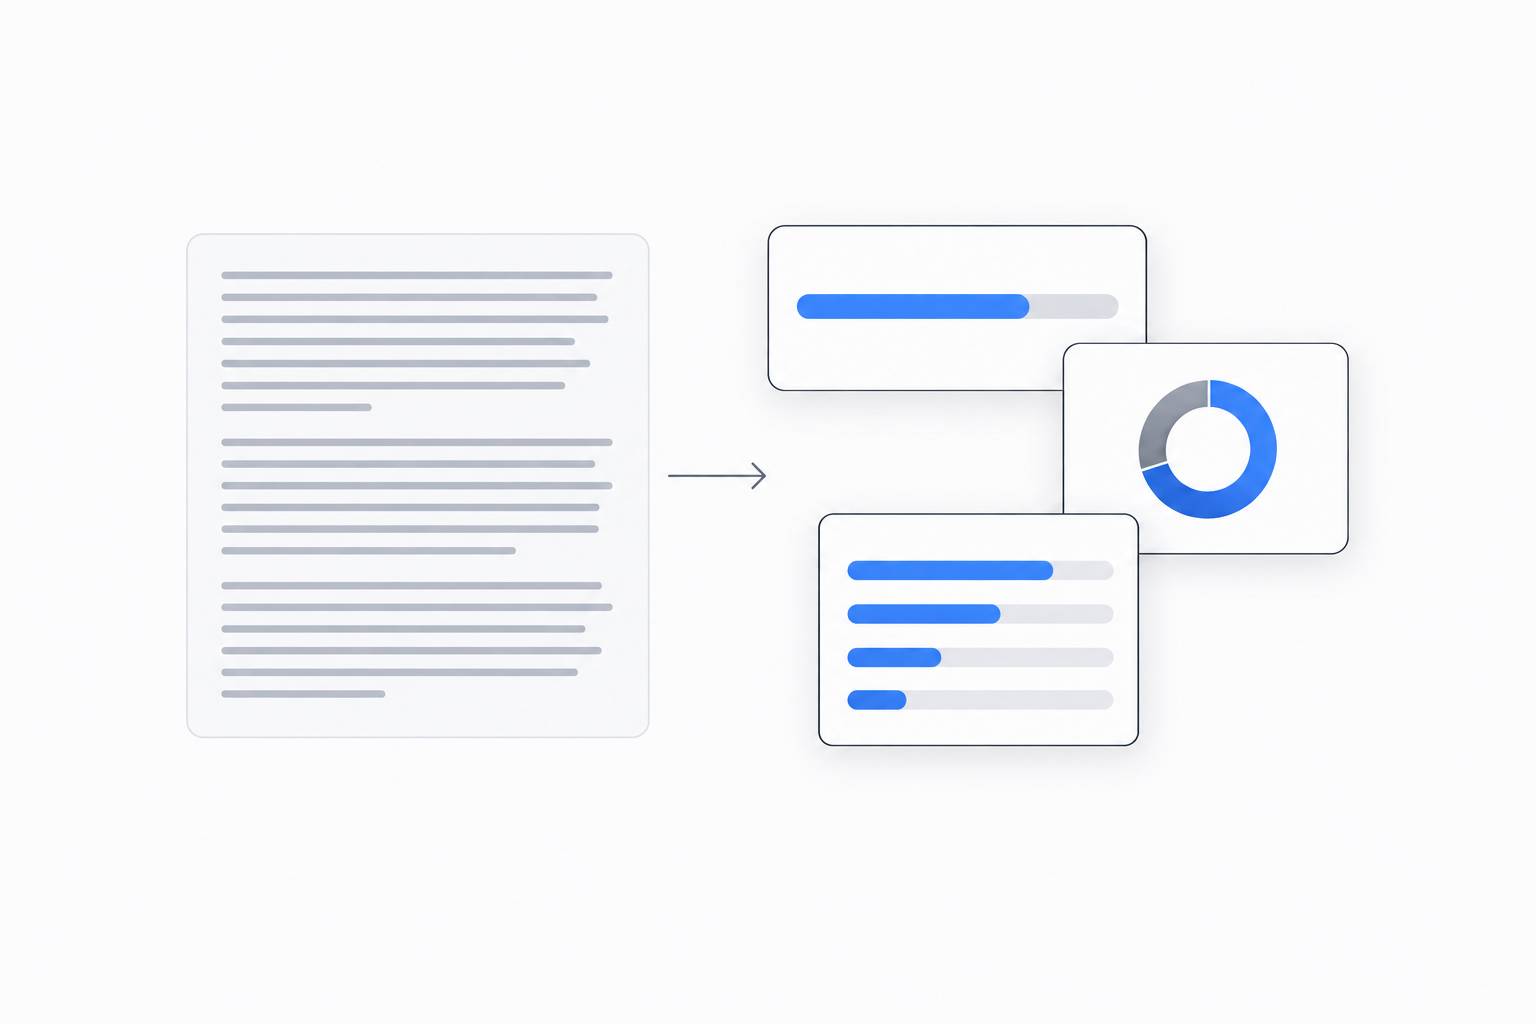
直接從您的工作區呼叫 Jev。
當您要求進行結構化評估時,Kollab Agent 會自動呼叫 Jev。您也可以透過命令列介面 (CLI) 手動執行,以便用於指令碼與自動化流程。
npm install -g @kollab/cli
kollab login

echo '{
  "state": "Help! My payouts have been failing for 3 days.",
  "questions": {
    "is_urgent": { "type": "noul", "instructions": "Does this convey urgency?" },
    "department": { "type": "choice", "instructions": "Which team should handle this?",
      "criteria": { "billing": "Payments, invoicing, refunds", "technical": "Bugs, outages, integrations", "sales": "Pricing, upgrades, new accounts" } }
  }
}' | kollab tool run jev --json
Kollab 模型庫的一部分。
與處理文本、視覺、影片及音訊任務的完整模型套件一起使用 Jev。
結構化判斷的應用案例。
使用 Jev 執行特定的評估任務。
效能基準測試。
針對大批量的分類任務,提供快速執行與高度一致性。
實際應用案例。
開發者與研究人員如何在正式環境中使用 Jev。
垃圾郵件與自動回覆偵測
Freek Van der Herten 在 639 毫秒內透過 3 個平行問題來處理新進的客服工單。這實現了每秒 48 次請求的處理量,而每月成本僅需 US$0.36。
金融研究一致性
Good Start Labs 使用 Jev 以高效且一致的方式來驗證大量的財務報告。
寫作風格檢查
Every.to 使用 Jev 評估文章草稿。該模型能以中位數 0.35 秒的速度,標記出人為植入的寫作瑕疵。
LLM 可觀測性評分
Langfuse 將 Jev 整合至他們的評估系統中,以自動化提示詞評分與回饋資料。
Cloudflare Workers AI 整合
Cloudflare 將 Jev 模型加入其 Workers AI 平台,用於全球邊緣運算推論。
種子輪融資發布
TypeSafe AI 籌集了 US$4000萬,致力於為軟體應用打造專屬模型。
結構化狀態管理
Jev 透過輸出結構化的遊戲狀態,驅動了遊玩《毀滅戰士》(Doom) 的官方展示。
常見問題。
Jev 是什麼?它與標準的聊天模型有何不同?+
Jev 是一個結構化判斷模型。它能輸出精確的布林值、選擇和評分。它完全跳過對話式文本,只回傳純資料。
我該如何在 Kollab 中使用 Jev?+
當您描述一個需要結構化判斷的任務時,Kollab Agent 會自動呼叫 Jev。您也可以透過終端機使用 `kollab tool run jev` 指令來直接呼叫它。
定價是如何計算的?+
輸入的 Token 費用為每百萬個 US$0.042 美元。輸出的 Token 則是完全免費的。
Jev 支援中文、日文和韓文嗎?+
是的。不過目前中日韓 (CJK) 語言的準確率仍低於英文。
信賴機率 (confidence probabilities) 絕對準確嗎?+
獨立審計顯示 Jev 的輸出機率並未經過嚴格校準。請將它們視為相對的、單調遞增的評分。我們建議對高風險任務進行抽查。
Jev 可以處理圖片或音訊嗎?+
Jev 只能處理最多 80,000 字元的純文字。您必須先將音訊轉錄或從圖片中擷取文字。Kollab 有提供像是 GPT Image 2 與 Grok STT 等其他模型,可用於直接處理多媒體內容。
開始使用 Jev 評估文本。
直接在您的工作區中執行大批量的分類與評分任務。